|
|
很多程式設計師或者理工科背景的朋友,剛接觸二級市場時都有過類似的經歷:
花兩天時間自學了點 Python 數據分析庫,從網上下載了一段歷史K線數據,寫了個雙均線金叉買入、死叉賣出的簡易策略。跑完回測那一秒,看著螢幕上那條近乎四十五度角穩定向上的資產曲線,年化收益率高達百分之八十,最大回撤居然不到百分之五。
那一瞬間,整個人心跳加速,感覺華爾街的頂級基金經理也不過如此,甚至開始在心裡盤算每個月靠這個策略提款,多久能把全職工作給辭了。
結果興沖沖把幾萬塊真金白銀充進交易所,實盤跑了不到三週,帳戶直接跌出一個深坑。原本回測裡百發百中的指標,在真實盤面上要麼頻繁被假突破來回打臉,要麼剛買進去就被突如其來的跳水打掉停損,最後扣除手續費,資金縮水了一大截。
很多人這時候開始破防,覺得量化交易全都是學術界編出來騙人的把戲。
把程式碼直接等同於提款機,這中間差了十萬八千里。量化交易的本質,既不是什麼神秘的黑科技,更不是用幾行均線代碼去猜測明天的漲跌。它是一門用嚴密統計學去度量風險、用冷血紀律把下注動作標準化的工程科學。
今天我們把自營量化團隊的底層工作流拆開,聊聊一個普通交易者想真正邁進量化大門,到底得踩過哪些水面下的暗礁。
第一道鬼門關:過度擬合,一場自己騙自己的數據邪術
量化新手最容易掉進去的無底洞,叫作過度擬合(Overfitting)。
如果你給一個裁縫一塊布,讓他給一個身高一米七五的普通人做一套西裝,這套衣服穿在大多數身材相近的人身上都不會太差。
但過度擬合是怎麼回事?相當於這個裁縫拿著放大鏡,把某個模特兒在昨天下午三點零五分時皮膚上的每一顆痘痘、每一個汗毛孔的起伏,全都精確剪裁到了布料上。這套衣服在昨天那一秒鐘無比貼合,可只要模特兒今天稍微深呼吸一下,整件衣服立刻崩線裂開。
很多人做策略回測時就是這個狀態:
先跑了一遍均線策略,發現過去三年收益率只有百分之十,覺得不夠好看;
隨手在代碼裡加了個過濾條件,要求RSI指標必須低於三十;
跑完發現某個月還是虧損,於是又加上成交量必須放大兩倍、布林通道開口必須向上;
前前後後疊加了十幾個參數,把歷史數據裡每一次虧損的單子全用人為設定的條件完美剔除掉。
這時候你的回測曲線自然漂亮得像一件藝術品。
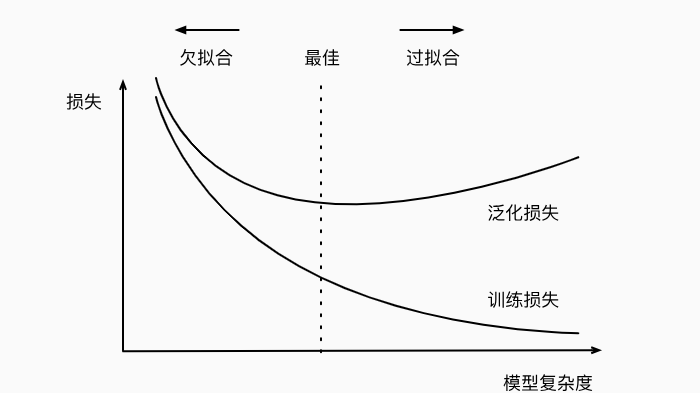
問題在於,市場未來的走勢絕對不會完美重複昨天的雜訊。
你疊加的那些精密參數,本質上只是在歷史行情的隨機噪音裡強行畫靶子。當這套策略面對未來的未知行情時,它的容錯率幾乎為零,實盤崩盤只是時間問題。
真正的量化研究員在開發策略時,追求的恰恰是極致的簡約:
- 邏輯必須具備可解釋的經濟學原理,而不是單純從海量數據中隨機碰運氣挖出來的數字巧合;
- 將歷史數據嚴格切分為樣本內數據與樣本外數據,用前幾年的數據尋找規律,再用完全沒有參與過運算的後幾年盲測數據進行檢驗;
- 對核心參數進行敏感度測試,如果某個均線週期從二十改為二十一,整個策略的收益率就直接腰斬,這種策略在實盤中毫無生存能力。
第二道鬼門關:被忽視的物理摩擦力,紙面富貴的粉碎機
在紙面回測的世界裡,一切都美好得像是生活在真空實驗室裡。
你的回測代碼會默認:只要價格碰到了我的掛單點位,這筆單子就能以精確的價格瞬間成交;平倉的時候,只要觸發停損,系統就能一分不差地精準跑路。
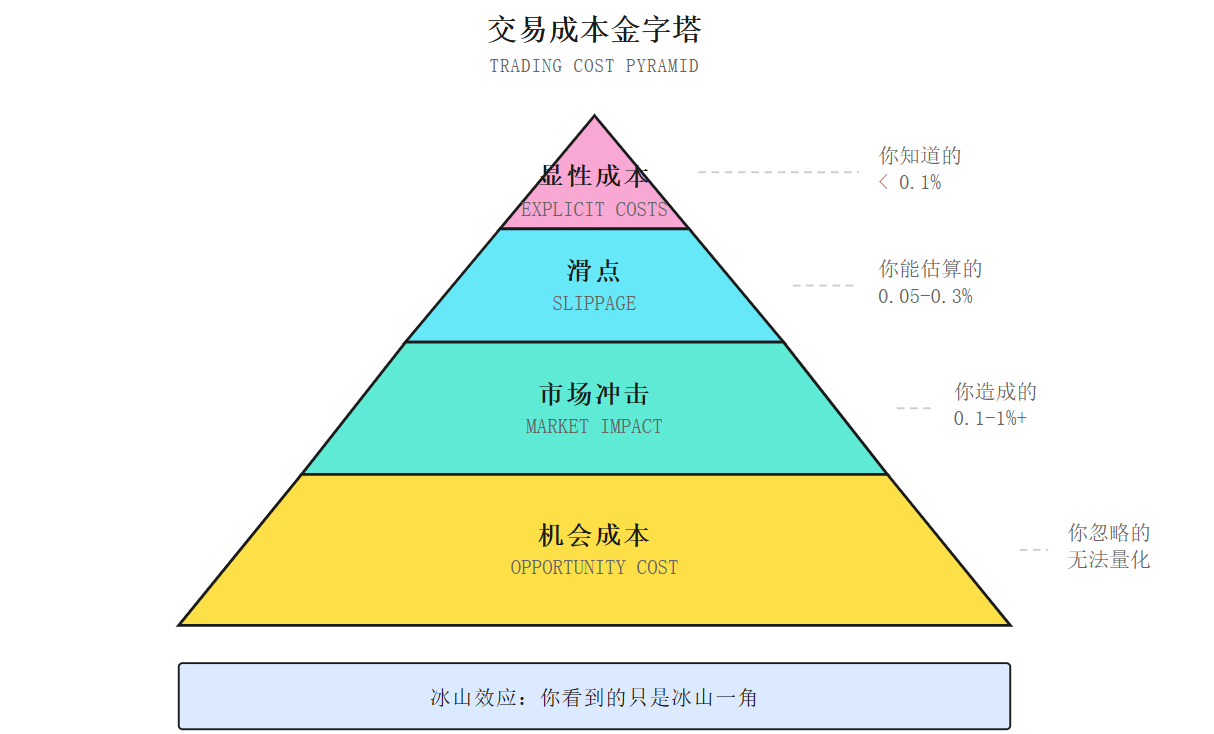
一旦進入真實的撮合世界,各類微觀物理摩擦力會像砂紙一樣,一層層磨光你的本金。
回測與實盤撮合的致命偏差
- 撮合滑價:在真實市場中,尤其是中小型代幣或非流動性高峰期,你的市價單會直接穿透好幾檔訂單簿。原本預期賺取百分之一的微小空間,進場時滑掉千分之三,出場時再滑掉千分之三,超過一半的理論利潤在撮合成交的瞬間就蒸發了。
- 流動性承接上限:回測時買入一百萬美元好像只是一個數字變化,但在盤面上,十萬美元的買單就可能把當前價格往上推升兩個百分點,你在拉高自己成本的同時,還成了其他量化演算法搶跑狙擊的靶子。
- 成交延遲與隊列損耗:在關鍵行情爆發時,交易所的撮合引擎往往面臨幾萬筆訂單擠兌。你的限價單排在幾百張機構大單後面,根本輪不到你成交;等輪到你時,價格早已調頭而去。
很多高頻策略或者超短線網格策略,在歷史回測中每天能產生幾十筆交易,靠著累積微小的波段獲利,複利曲線驚人。
但在真實環境中,每筆交易都要被券商抽取佣金、被做市商吃掉買賣價差。如果你的單筆平均獲利空間覆蓋不住兩到三倍的平均滑價與手續費,這種策略跑得越勤奮,帳戶失血的速度就越驚人。
第三道鬼門關:偷看答案的未來函數,代碼裡的隱形幽靈
很多剛接觸量化寫代碼的朋友,最常犯也是最隱蔽的致命錯誤,就是在程序裡不小心調用了未來函數(Look-ahead Bias)。
這在代碼層面上是個極容易忽略的陷阱。
比如你的策略邏輯是每天收盤前五分鐘判斷今日走勢,如果今天是陽線就買入。但你在寫代碼時,引用了當天的收盤價或者當天的最高價數據。
在計算機回測歷史數據的時候,那天的K線已經全部走完了,程序能瞬間讀取到當天的最終收盤價,提前知道今天收出了一根大陽線,於是精準在最低點附近掛單買入。
這相當於你拿著明天的報紙去買今天的彩票,回測勝率當然能高到嚇死人。
但在實盤運行的當下,時間是單向流動的。在收盤前那一分鐘,今天的收盤價根本還沒有定型,最後幾十秒隨時可能出現反轉砸盤。
還有更常見的倖存者偏誤:
在挑選股票或者代幣股票池時,直接選取了當前市值排名前一百的品種進行過去五年的歷史回測。
你完全忽視了那些在三年前市值很高、但在過去兩年裡已經破產退市或者歸零的品種。你在回測一開始就已經替系統過濾掉了所有暴雷失敗者,留下來的全是長跑冠軍,得出來的收益率自然被嚴重虛增。
新手構建量化實踐工作流的四步清單
想要避開這些致命暗礁,把量化工具真正用作提升勝率的武器,請按照這套自營機構通行的標準步驟打底:
第一步:從真實的市場邏輯出發,提出可證偽的假說。
永遠不要拿著一堆數學工具去隨機挖掘數據。先用你的雙眼和常識觀察市場:比如某些品種在重大宏觀數據落地後的半小時內,是否往往會出現流動性過度反應後的均值回歸?或者某些具備長期趨勢的品種,在突破二十日高點後是否存在波動率擴張效應?
先有明確的博弈邏輯,再寫代碼去驗證它,而不是讓代碼替你瞎碰運氣。
第二步:洗乾淨你的數據源。
花時間把歷史數據裡的除權除息、點差變化、合約換月貼水以及退市標的全部還原。如果數據底層就是髒的,哪怕算法再高級,算出來的也只是一堆毫無意義的垃圾結果。
第三步:把部位管理寫進系統底層。
一套合格的量化系統,代碼裡超過一半的權重是在計算部位。根據帳戶淨值的即時波動,引入動態部位縮放機制:市場波動率放大時自動降低槓桿手數,系統進入連敗回撤期時強制收縮單筆下注比例。
讓風控模組獨立於信號模組運行,在策略發瘋之前擁有隨時拔掉電源的最高權限。
第四步:用微型實盤進行壓力測試。
回測成績再好,也只能算拿到了一張入場券。
拿出總資金的百分之一到二,接上交易所的真實 API 接口,讓代碼在活生生的市場裡運行至少兩到三個月。
去實地感受真實的延遲、滑價和極端行情插針。只有當實盤產生的數據分佈,與你的樣本外回測數據具備高度一致性時,這套系統才具備逐步承載大部隊資金的資格。
量化這條路,從來不是給懶人躺著賺錢的捷徑。
它的全部價值,在於幫我們克服恐懼與貪婪的人性弱點,把混亂的情緒交易轉化為清晰的概率博弈。拋開對暴富神話的幻想,學會用工程師的嚴謹去敬畏市場的每一筆磨損,你的代碼才能真正成為保護資產的盾牌。
|
|


 发表于 2026-10-22 16:03